Long Autoregressive Video Generation
Tips:
- Forcing 可以理解为“强制引导”,即施加约束。
有几个关键问题:
- Teacher 和 Student 打分的时候,都是所有 chunk 一起输入并打分。
- Student 在 Rollout 的时候,有几种方法?
- 并行,比如 Causvid,是从数据集取得数据加噪后,然后7个chunk并行一次前向,并没有kv cache
- 串行:逐个 chunk 生成,每个通过 kv cache 看到之前的所有干净 kv。
Causvid:将 DMD 引入Streaming Video
Paper:From Slow Bidirectional to Fast Autoregressive Video Diffusion Models, CVPR 2025
TL; DR:把双向Teacher蒸馏成单向Student
核心工作:
- 每个 chunk 内保持双向注意力,chunk 之间用因果掩码
- 先用 ODE 初始化学生,然后进入 DMD 蒸馏
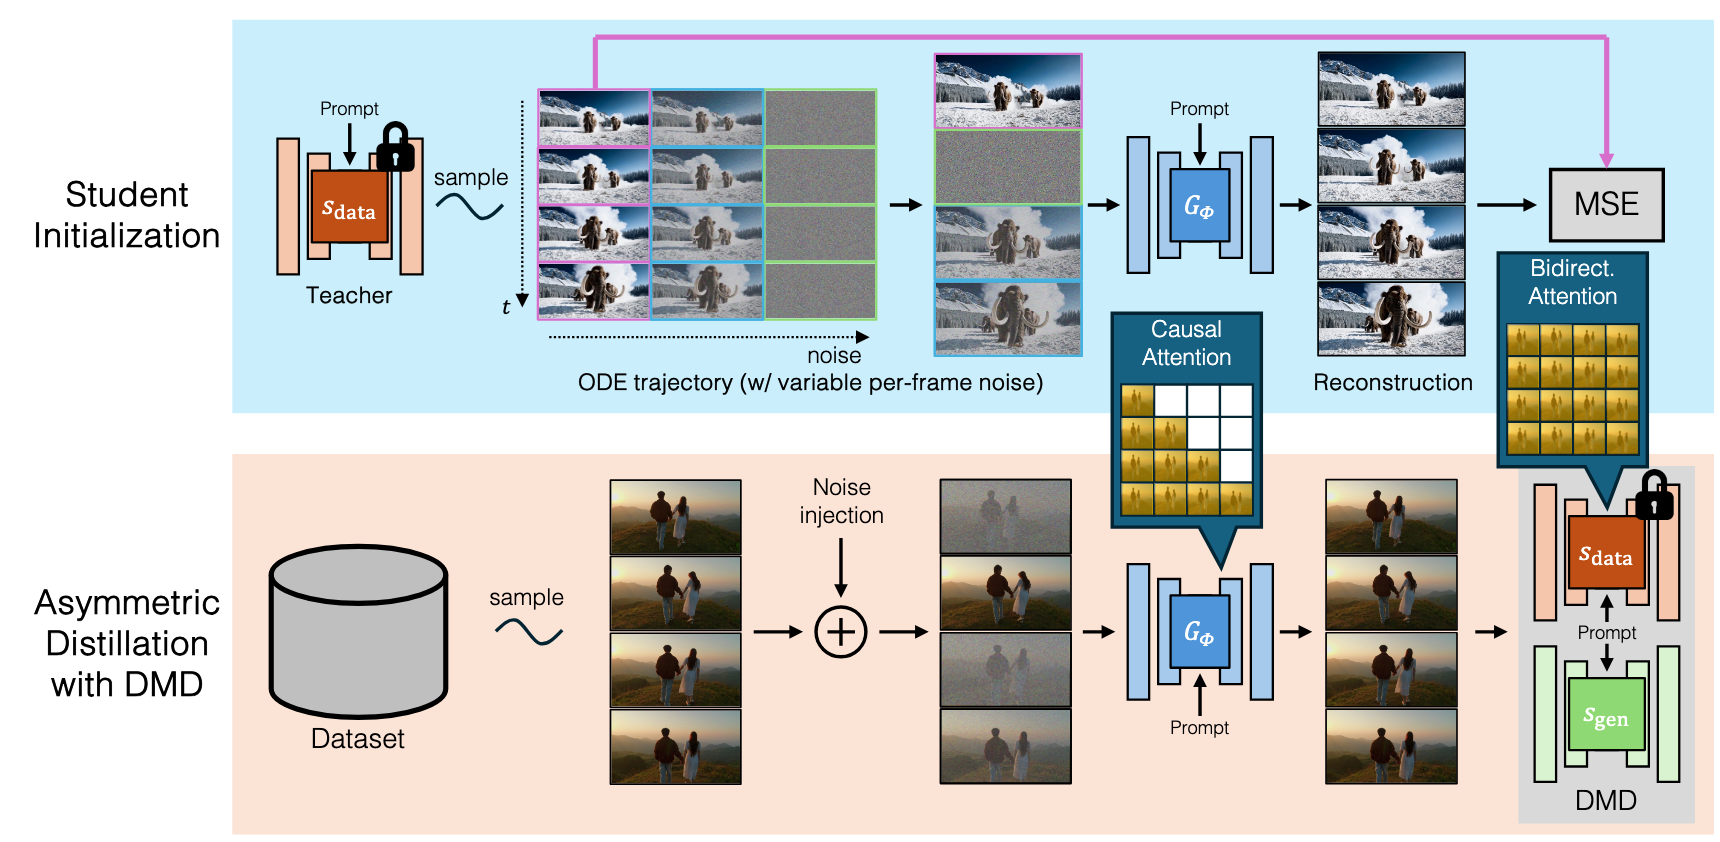
通过阅读代码,详细的 Pipeline 如下:
- Stage 1: ODE 初始化。
- 将 Teacher 权重复制,然后注意力改成块内双向、块间因果。
- 用教师的 ODE 轨迹蒸馏。7 个 chunk 全部并行一次前向输入 Student(teacher forcing,无 rollout)
- 每个 chunk 从轨迹中独立采样噪声水平:chunk 内一致、chunk 间不同
- Student 从该噪声状态一步直接预测 x0,回归到轨迹终点(MSE)
- Stage 2: Teacher Forcing
- 取真实视频,然后加噪,不同chunk噪声水平不一样。
- 然后 7 个 chunk 一起输入 Student,预测 clean video。
- 7 个 chunk 统一加噪, 然后 fake score(注意是双向) 和 real score 打分。
- 更新 Student。
Self Forcing:解决训练推理不一致的问题
Paper:Self Forcing: Bridging the Train-Test Gap in Autoregressive Video Diffusion,NIPS 0225
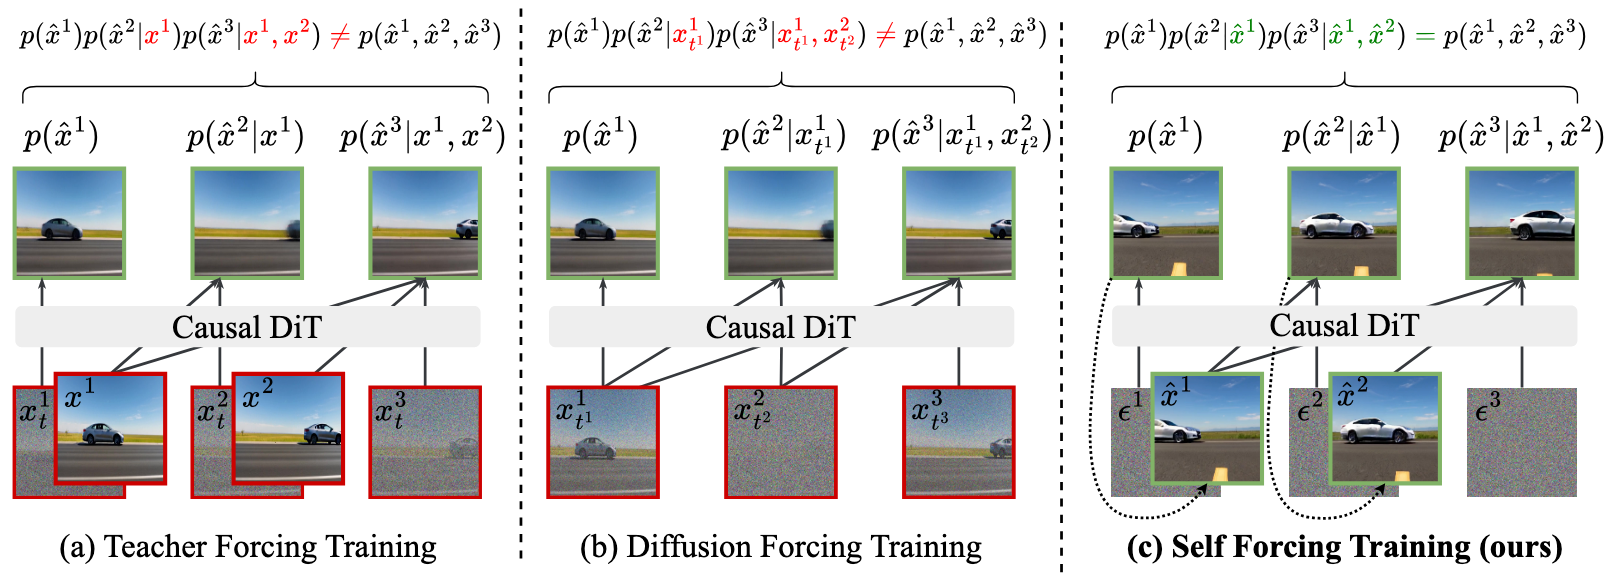
训练的时候,rollout就用自己输出的
通过阅读代码,详细的 Pipeline 如下:
- Stage 1: ODE 初始化。
- 将 Teacher 权重复制,然后注意力改成块内双向、块间因果。
- 用教师的 ODE 轨迹蒸馏。7 个 chunk 全部并行一次前向输入 Student(teacher forcing,无 rollout)
- 每个 chunk 从轨迹中独立采样噪声水平:chunk 内一致、chunk 间不同
- Student 从该噪声状态一步直接预测 x0,回归到轨迹终点(MSE)
- Stage 2: Self Forcing
- 采集一个 Prompt
- Student 自回归的生成 7 个 chunk。
- 每个 chunk 4 步去噪。
- 每个 chunk 会 attention 到之前的所有历史kv cache。
- 当前 chunk 计算完之后,会再进行一次 forward,存放干净的 kv cache。
- 7 个 chunk 统一加噪, 然后 fake score(注意是双向) 和 real score 打分。
- 更新 Student。
- 训练节奏:critic 每步都更新,generator 每 5 步更新一次;200 步后开 EMA;总计 600 iterations
注意这里 Student Rollout 的时候是先预测x0,再加噪去噪:
1 | |
Causal Forcing:新增了一个 AR Teacher
Paper:Causal Forcing: Autoregressive Diffusion Distillation Done Right for High-Quality Real-Time Interactive Video Generation,arxiv 2026
做实时交互式视频生成,主流方案是把双向视频扩散模型蒸馏成少步自回归模型,但"看未来"的教师配"只看过去"的学生会留下架构鸿沟,导致 Self Forcing 这类 SOTA 明显不如等价的双向蒸馏。这篇论文指出根因在 ODE 初始化:MSE 回归要求配对数据帧级单射,而双向教师的 PF-ODE 只在视频级单射,学生只能学成条件期望,结果就是模糊。解法很干净——先用 teacher forcing 训一个自回归扩散模型当教师,再用它做 causal ODE 蒸馏,最后接原样 DMD。
总结:在 Self Forcing 的基础上,新增了一个阶段,就是把之前的 Teacher 先微调成一个 AR Teacher。
Causal Forcing++:解决初始化很昂贵的问题
在 Causal Forcing 的基础上进行了优化改进。论文认为 ODE 初始化要离线预生成教师的很多轨迹,很昂贵,于是提出把这个初始化也进行优化。
论文提出了 Causal CD。核心: 既然目标是「一步到位映射到终点」,那我不需要知道终点长什么样,只需要知道「沿轨迹再走一小步,我应该还是去同一个终点」。
左边是 tt 时刻的点,右边是 teacher 走一步之后的点,两者应该映射到同一个终点。于是监督信号从「老师跑 48 步 + 存轨迹」变成「老师在线走 1 步」。
- 从真实视频取第
帧及其真实历史帧; - 对第
帧加噪,得到 ; - AR Teacher 基于真实历史,对
做一次 ODE 步,得到 ; - 在线 Student 处理
,得到终点预测 ; - EMA Student 处理
,得到终点预测 ; - 计算
,并乘以时间权重; - 只更新在线 Student,使两个终点预测保持一致;
- 用在线 Student 的参数更新 EMA Student。
Rolling Forcing-解决误差积累问题
Paper: Rolling Forcing: Autoregressive Long Video Diffusion in Real Time
Self-Forcing 的问题:块
Pipeline:
1 | |
每个窗口的操作:
- 一次前向处理整个窗口:5 个块拼在一起输入,timestep 呈阶梯(shared_timestep,最老块最干净、最新块纯噪声)
- 输出 5 个块的 x0 预测,各自重新加噪到下一级存回 noisy_cache(no_grad,199-221 行)
- 只把最老块以 t=0 干净态写入 KV cache(236-246 行,denoised_pred[:, :num_frame_per_block]),它已到最低噪声级,正式完成
- 窗口右滑一格,新块以纯噪声进入
感觉就像“视野变长了”,有未来的视野,可以根据未来的视野(虽然比较模糊)保持比较好的一致性。
Context Forcing-解决长rollout问题
Paper:Context Forcing: Consistent Autoregressive Video Generation with Long Context
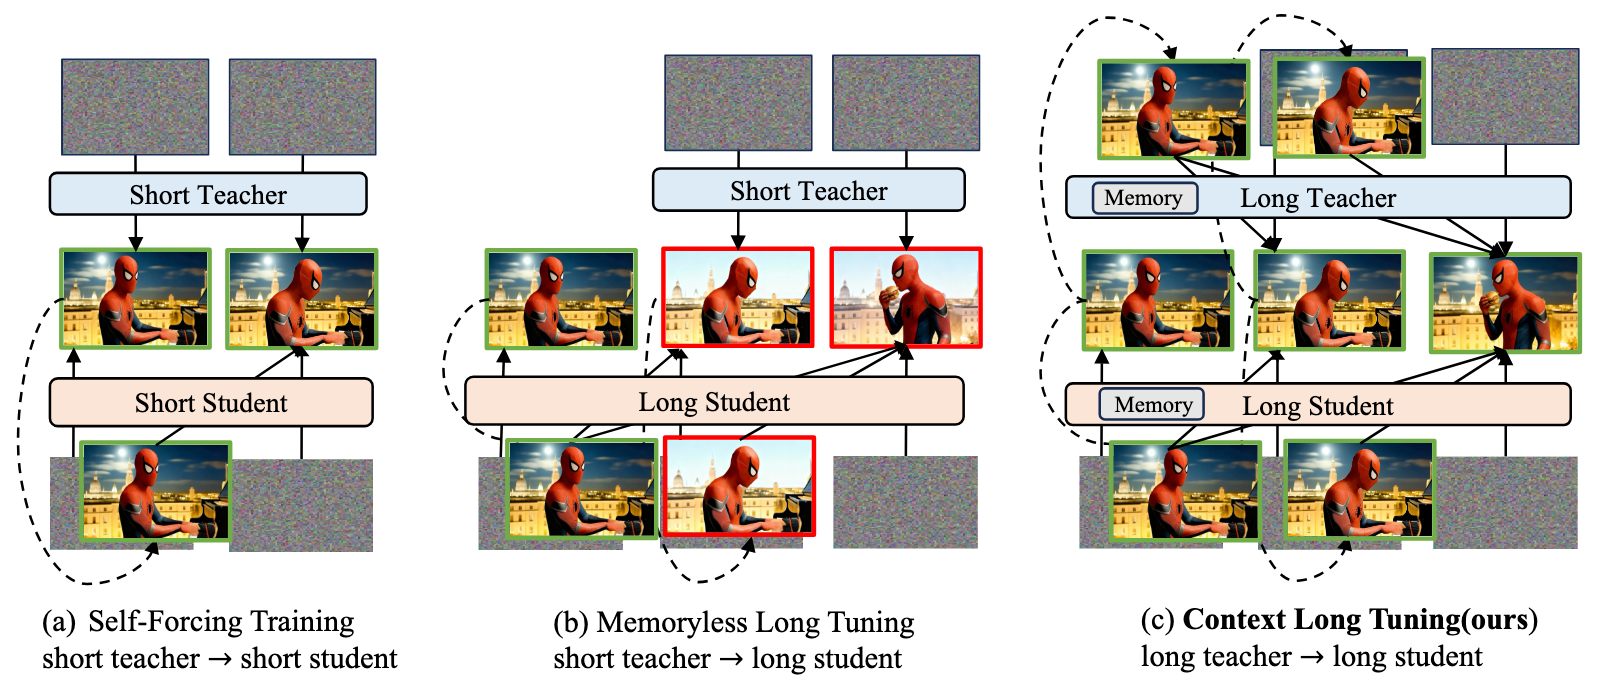
论文提到,现有流式视频模型存在如下两种范式:
- Self-Forcing 类:Teacher 和 Student 都很短。
- LongLive 类:Student 很长,但是 Teacher 看到的信息还是很短。
- Context Forcing:Teacher 和 Student 都很长。
所以
- Teacher 用长上下文的老师,在 Wan2.1-1.3B 上用 Stable Video Infinity 方式 LoRA 微调。
- Student 也有长上下文。Memory 机制如下:
- Attention Sink
- Slow Memory:很久以前重要的信息,如果相邻 Token 变化很大,说明发生了状态变化,就存下来。
- Fast Memory:最近的若干 chunk
训练分成两个 Stage:
- Stage 1: Self Forcing DMD
- Stage2: Rollout 长度从21帧变成105帧
One Forcing
解决的核心问题:One-Step 质量一般。
核心是加入了 GAN loss。
完成 pipeline 如下:
每个 step
1 | |
每 5 个 step(generator 步,额外做)
1 | |
两种损失如下:
1 | |
其他:论文用 register token 压缩视频的feature:
1 | |