DMD 与 DMDv2
Paper:One-Step Diffusion with Distribution Matching Distillation,CVPR 2024
传统的扩散模型虽然生成图像质量极高,但很慢 。
许多“蒸馏”方法要么生成质量不好,要么在训练时需要完整多步去噪轨迹,导致计算成本很高 。
DMD 解决的核心问题就是:如何在几乎不损失图像质量、不增加训练成本的前提下,把多步扩散模型变成一个只需要单步前向传播的极速生成器。
如何解决
核心思想:不强求“单步生成器”去精确模仿原模型每一步的降噪映射轨迹,而是强求它们生成的“图像分布”在统计上和原模型一模一样 。
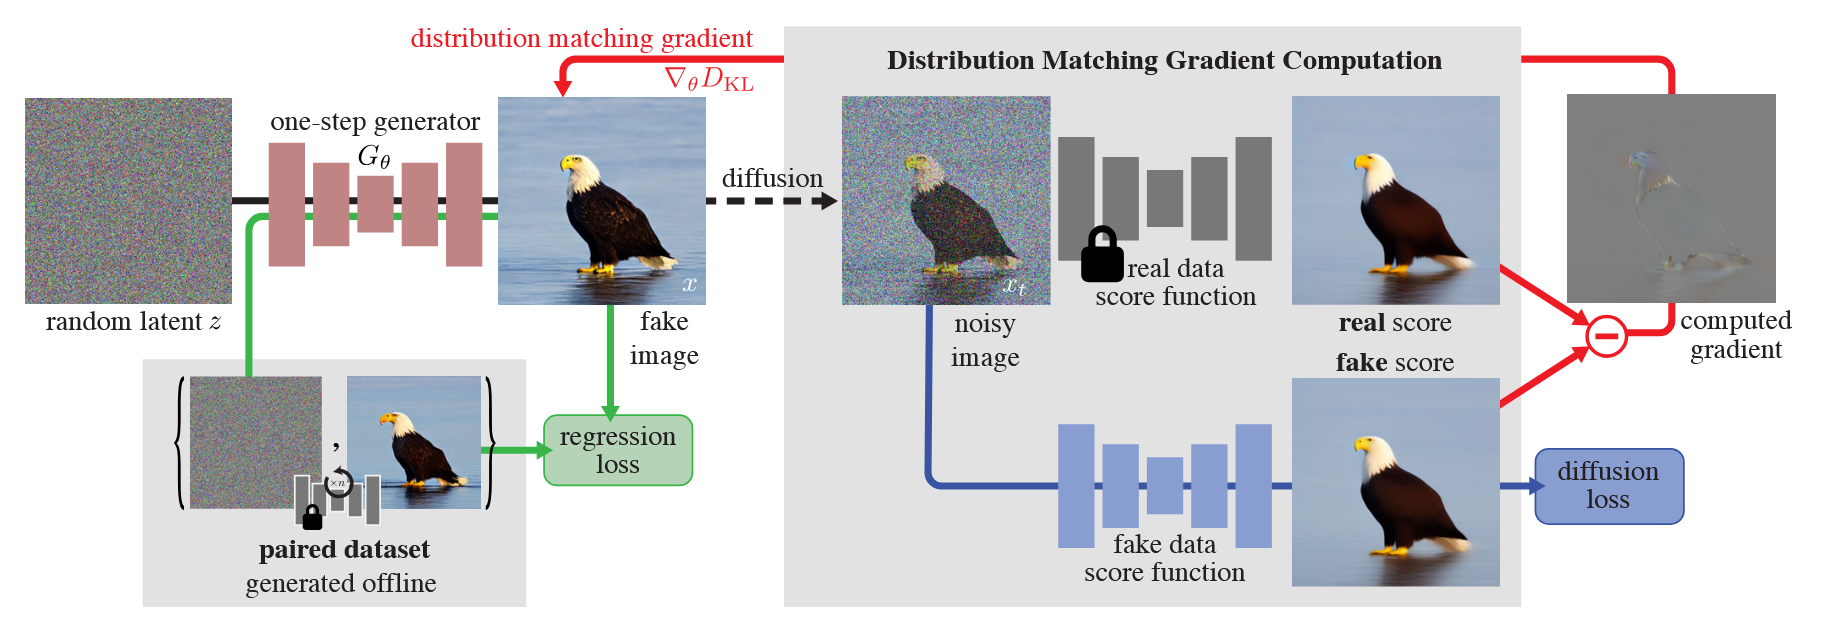
- 输入一个随机噪声,然后 student 进行一步去噪。
- 然后对去噪的 image 再次进行加噪。
- teacher score model 前向传播,得到梯度。
- fake score model 前向传播,得到梯度。
- 两个梯度做差,直接构造 student 的梯度方向,更新 student。
另外,regression loss 是为了防止模型塌陷。提前离线用一批噪声对 teacher 进行前向传播,得到配对的数据。然后训练的时候,student 用同样的噪声前向传播,然后计算 LPIPS 损失。
训练的时候是交替训练的,student model 和 fake score model交替训练。
- fake score model 的输入并不是完全随机噪声,所以不能直接复用 student model(因为输入是随机噪声)
- 如何训练 fake score model呢?用student 生成的图,然后加噪输入到score model,预测干净的图。
接下来是 DMDv2
Paper:Improved Distribution Matching Distillation for Fast Image Synthesis
改进点:
- 去掉 regression loss
- 因为需要大量预计算的pair data,很贵
- 会把student 绑定到 teacher 的轨迹上
- 多更新几次 fake score model
- 论文发现去掉 regression loss 后容易炸,原因是 fake score model 的更新比较慢
- 改成了 5次 fake score model update + 1 次 student model update 即可。
- 加入 GAN loss
区别
DMD v1:
1 | |
DMD v2:假设schedule:
1 | |
推理:
1 | |
训练:
1 | |