从 RoPE 的长文本外推到高分辨率图像生成
引入
问题:模型在预训练时只见过最大长度为
一种比较粗暴的方式是
- 假设你想把上下文窗口扩大
倍(比如扩大 4 倍,即 ) - 原本第
个 token 的位置坐标是 。 - 把所有位置坐标都除以
(也就是除以 4)”,变成了 。 - 这样一来,不管输入文本有多长,经过缩放后的位置坐标永远被严格限制在
的安全范围内。
但是有一个问题:模型整体的高频敏感度会被破坏,比如原本微观上挨着的两个Token,整体缩放后的相对位置会强行压缩。
所以后面提出了 YaRN,核心就是:低频大力压缩,高频率少压缩。
- 高频区域不处理。
- 低频区域进行缩放。
- 中频区域,用一个平滑的曲线衔接。
- 然后在上下文长度增加后,注意力机制的候选词会变多,于是论文在计算Softmax之前乘上了一个温度系数.
拓展到 DiT
DyPE
那么在高分辨率图像生成领域,是否也可以借鉴这个思路?
如果对整个去噪时间进行分析,可以发现:
- 低频部分:比如宏观结构,在早期阶段就快速收敛定型了。
- 高频部分:直到去噪的晚期部分,还在不断演化。
所以位置编码没有必要一直用一个固定强度去压缩。
- 去噪早期:高压缩
- 去噪晚期:不压缩
具体而言,DyPE 引入了一个分段函数
具体的解决方法如下:
其中
代表相对波长, 越大代表波长越长,频率越低。 :低频区下限阈值。一个预设的超参数,用来界定哪些频率属于“必须严格保护的低频区”。 :高频区上限阈值:一个预设的超参数,用来界定哪些频率属于“需要保持原汁原味的高频区”。 :时间动态缩放系数。这是 DyPE 最核心的创新点:它让原本静态的阈值 和 能够随着扩散时间步 的改变而动态变化
可视化如下:
1 | |
SEGA
前文的 DyPE 是从时间角度,对RoPE进行了调整。而 SEGA 则是在内容上入手,对RoPE进行了调整。
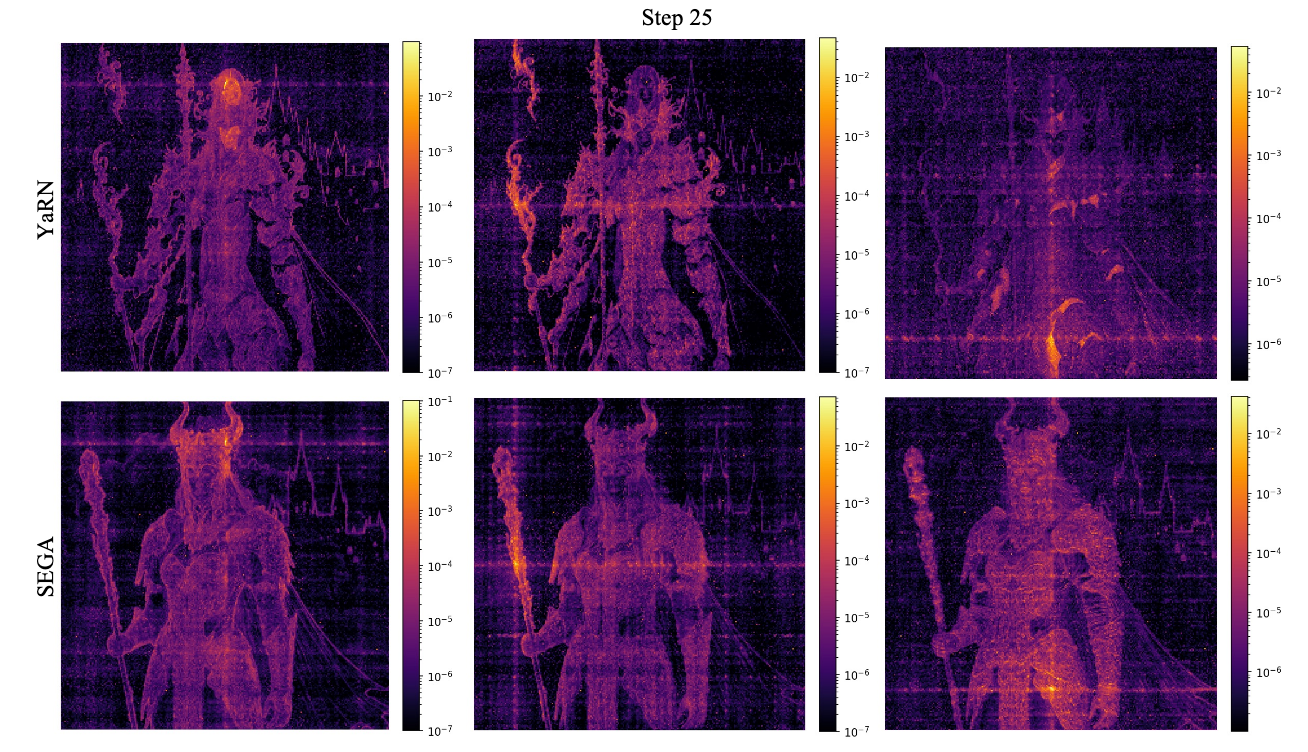
Core Motivation:图像在去噪的不同阶段、不同图片内容之间的频谱分布差异巨大(例如雾湖与繁华集市),静态缩放无法适应这种动态变化。
- 对当前 Step 对 Latent 减去均值,进行 2D
快速傅立叶变换(每个Channel)。
- 提取轴向剖面:沿着高度和宽度两个轴进行分析。
- 垂直轴剖面:把 2D 频谱在水平方向上把能量全部平均
- 水平轴剖面:把 2D 频谱在垂直方向上把能量全部平均
- 这个能够看出图像在横向和纵向上的高低频占比。
- 如何使用:如果能量低,就是低频;如果能量高,就是高频,
- 提取径向剖面:以频谱中心为圆心,画出一圈圈的同心环,计算每一个环上的平均能量,从而得到一个由内向外的
1D 分布。
- 距离中心越近,代表低频的宏观结构。
- 距离中心越远,代表高频的微观纹理。
- 如何使用:对径向剖面,计算 Wiener 熵,也就是射频平坦度,可以协助判断我们的逐个Channel缩放的发作时机,如果在早期,都是噪声,那么能量会很平坦,我们就暂时不操作,后期再操作。
- 提取轴向剖面:沿着高度和宽度两个轴进行分析。
I-MAX
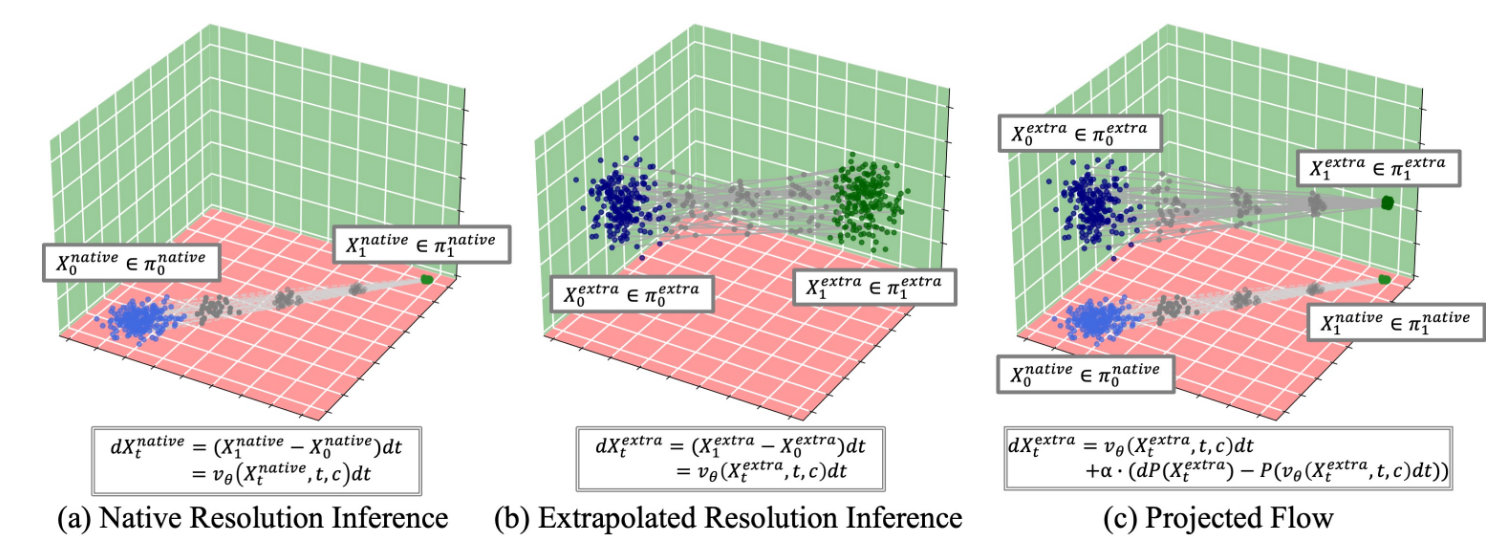
核心 IDEA:高分辨率图像空间中的每一个 Flow 在低分辨率空间中都有一个对应的投影。
然后在高分辨率去噪的时候,时刻用一个低分辨率的版本进行 CFG 引导。
FouriScale
Core Insight:不能只在空间域看图像,必须去频域找原因。
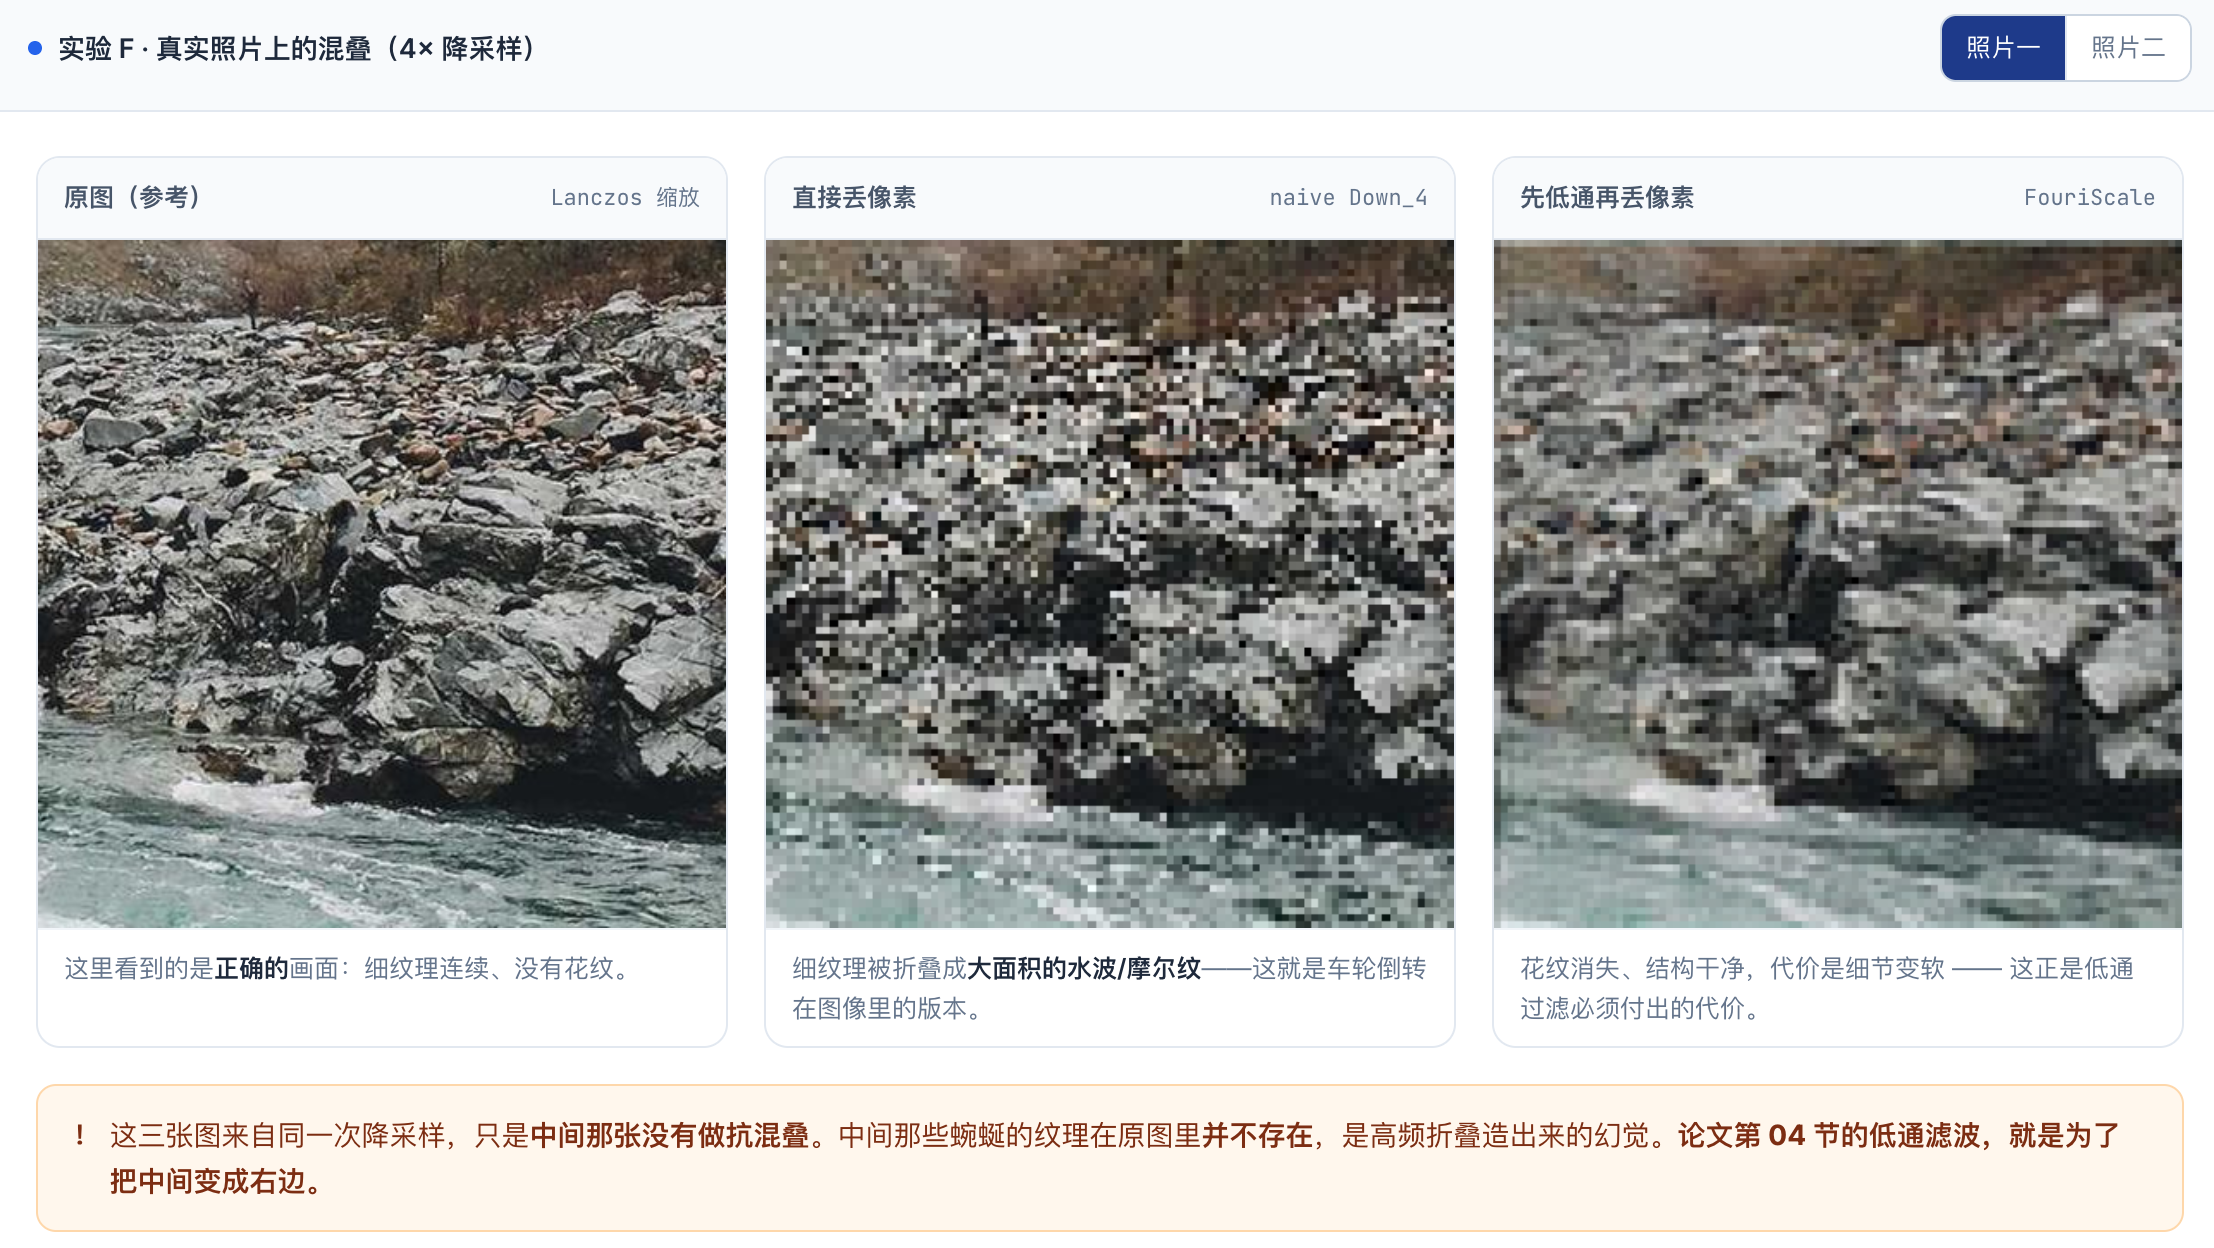
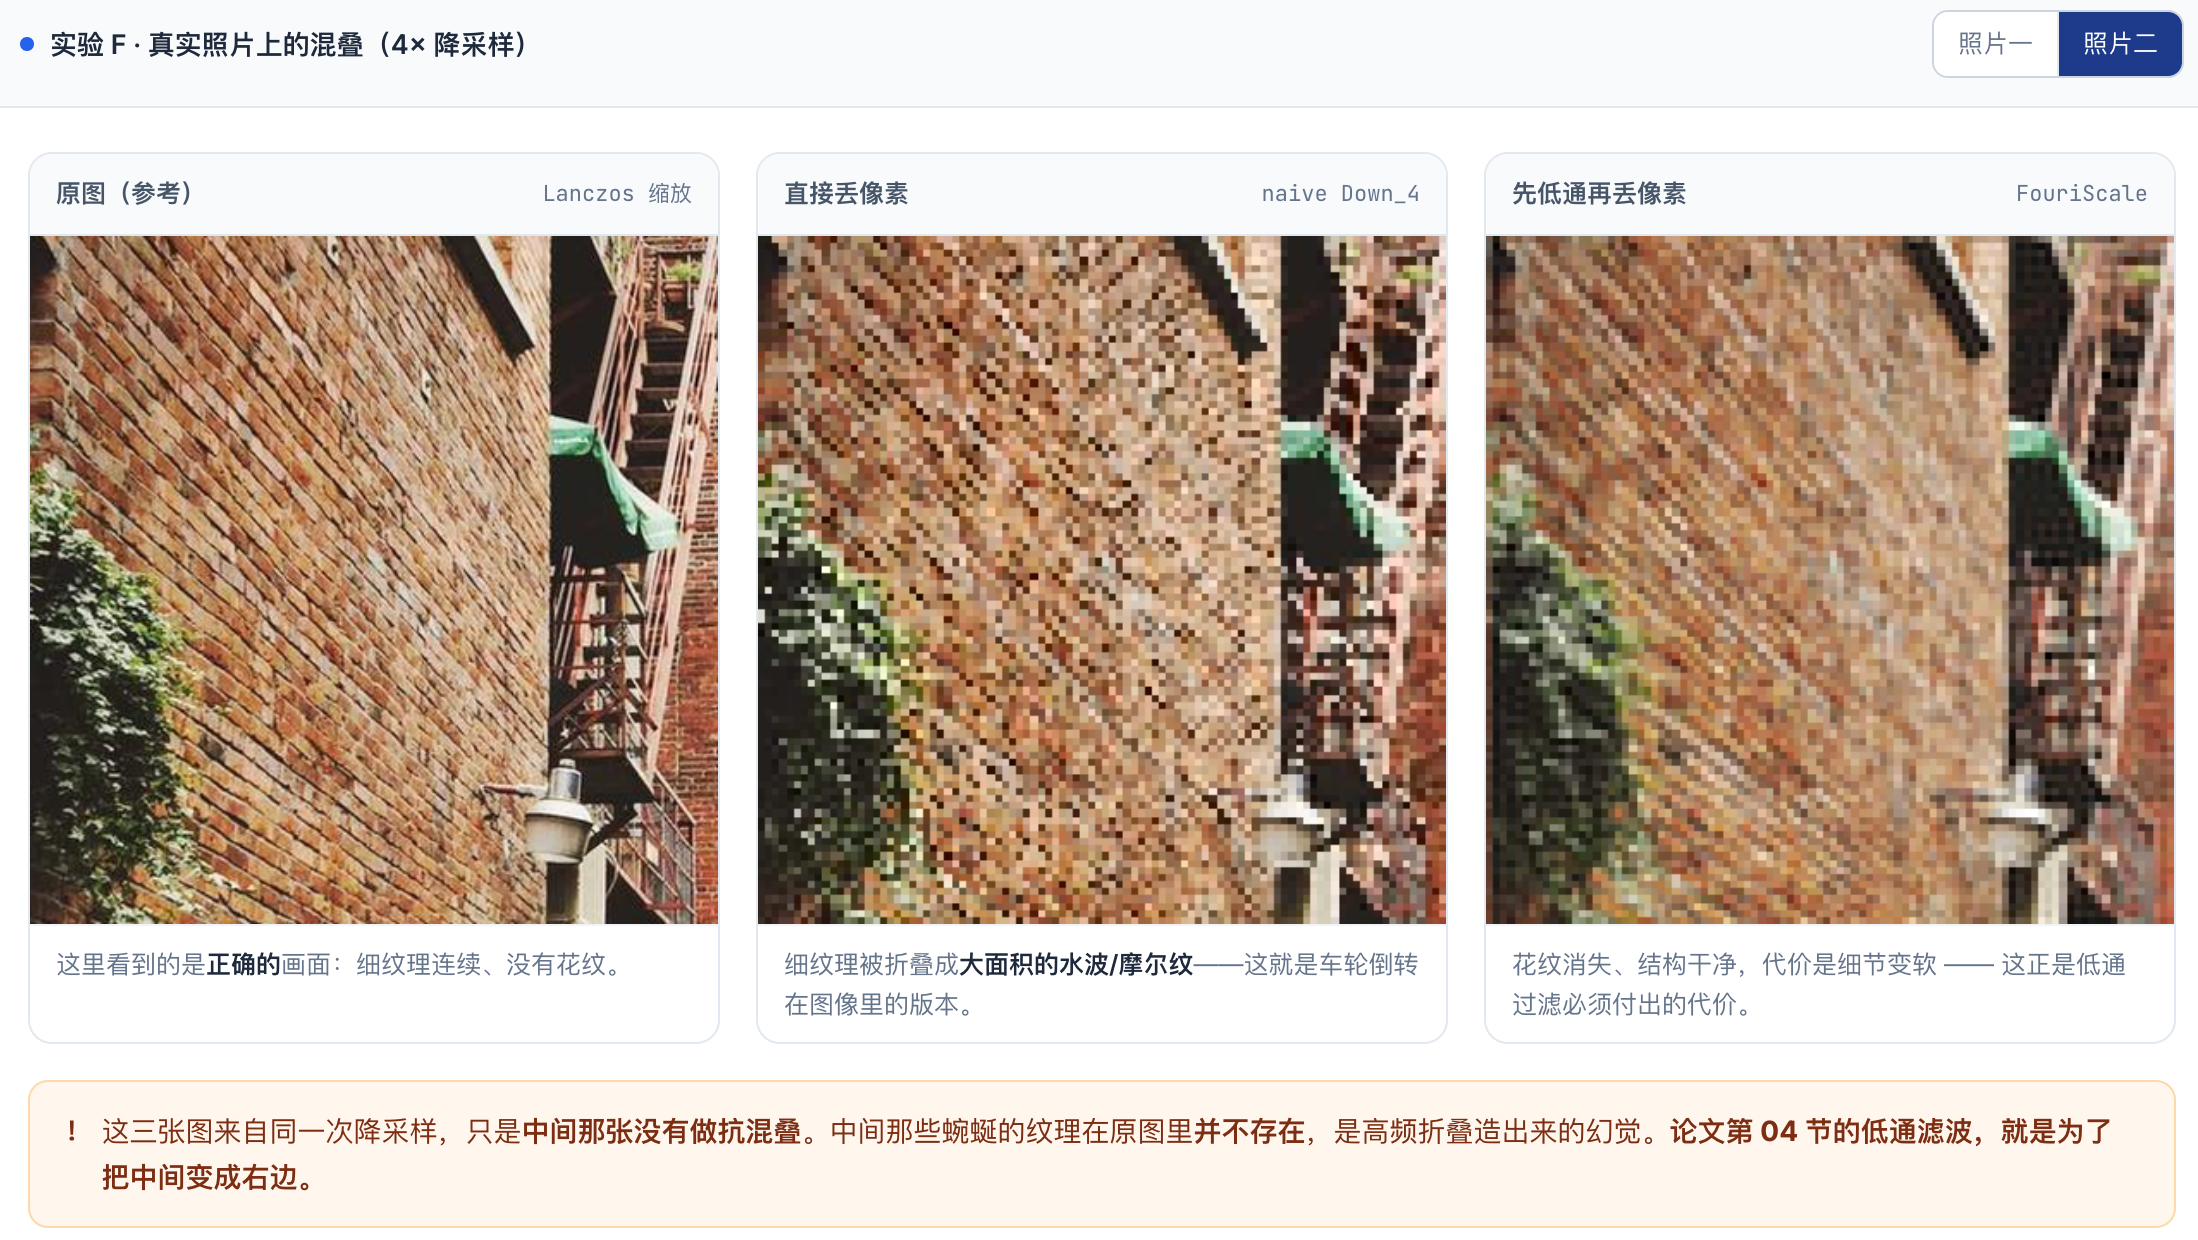
观察上面的两组照片:
- 中间图:直接下采样。原本的高频细节(石头),会折叠出一大片伪造的低频区域。扩散模型在看到这种大波纹的时候,就可能会误认为这里有一个大物体。
- 右边图:先低通滤波,再下采样;但是这样的话,细节变模糊了。所以论文的 Core Idea:用右边图定下骨架,用一个分支补充细节纹理。
论文的策略:
- 前
步:全量启用 FouriScale(空洞卷积 + 严格低通滤波),锁定宏观结构; 步:空洞倍率和滤波程度线性衰减(退火); 步之后:切回原版预训练 UNet 卷积层,专注于局部高频质感与微结构的打磨。
HiFlow
Core IDEA:
- 级联式生成。
- 在低分辨率生成的过程中,记录采样轨迹;
- 在高分辨率生成过程中,构建Reference Flow
那么具体是怎么做的呢?
- 在 Low-Resolution 下进行完整去噪,并记录轨迹。
- 构建 Reference Flow:在每个时间步
,将单步预测的 插值放大到目标大图。 - 大图起点:小图去噪到中间时刻
,将其预测的 插值放大并添加噪声,作为大图的起点。 - 然后对于每个
: - 将大图预测的
和 Reference 的 同时送入低通滤波器,过滤高频细节。计算差值后,补偿给大图。 - 利用 Reference Flow 的加速度和大图自己的加速度进行差值对比,通过 Detail 补偿大图的速度更新方向。
- 将大图预测的
具体到代码细节:
对于 Stage 0:
1 | |
然后逐级提升分辨率
DemoFusion
整体的 Pipeline 如下:
- Phase 1: 在低分辨率下,生成一张图。
- Phase 2~S: 逐级分辨率放大
- 与上一个 Phase 的图,经过双三次插值后放大,然后加噪声残差融合
- 局部路径:每个局部块都要进行一次 forward
- 全局路径:用空洞卷积进行 forward
- 局部去噪结果在重叠区域进行加权平均;全局结果再融入进去。
PixelRush
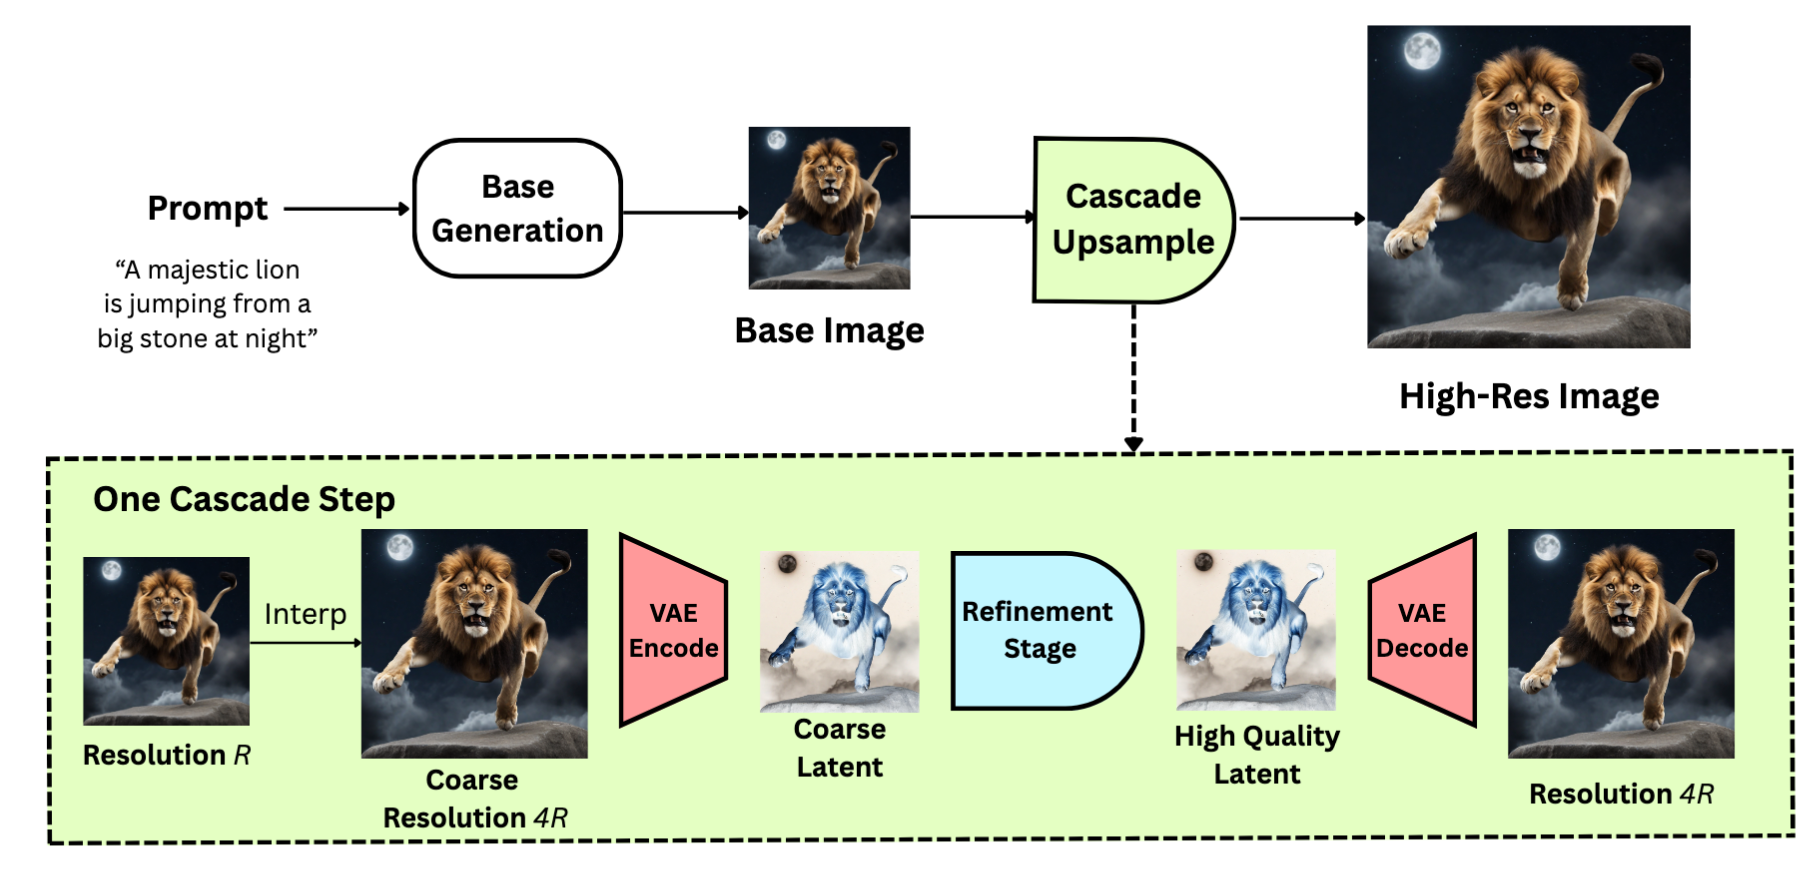
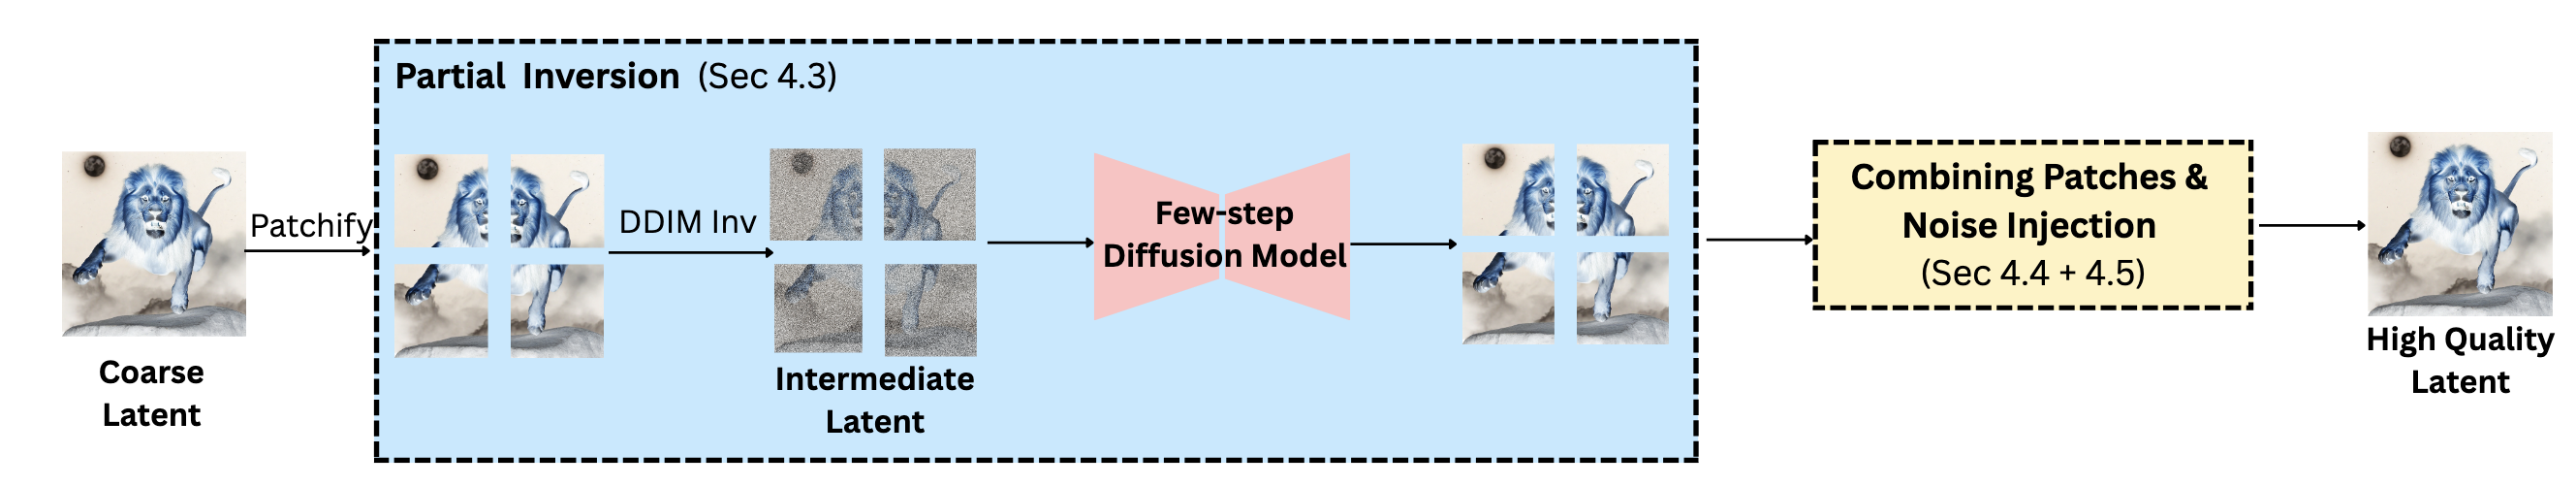
ARea
主要的 Pipeline 如下:
- Phase 1:粗粒度的全局注意力
- 将 K 和 V 进行空间块降采样,然后将空间网格划分成局部块,选取中心的 Token 作为代表
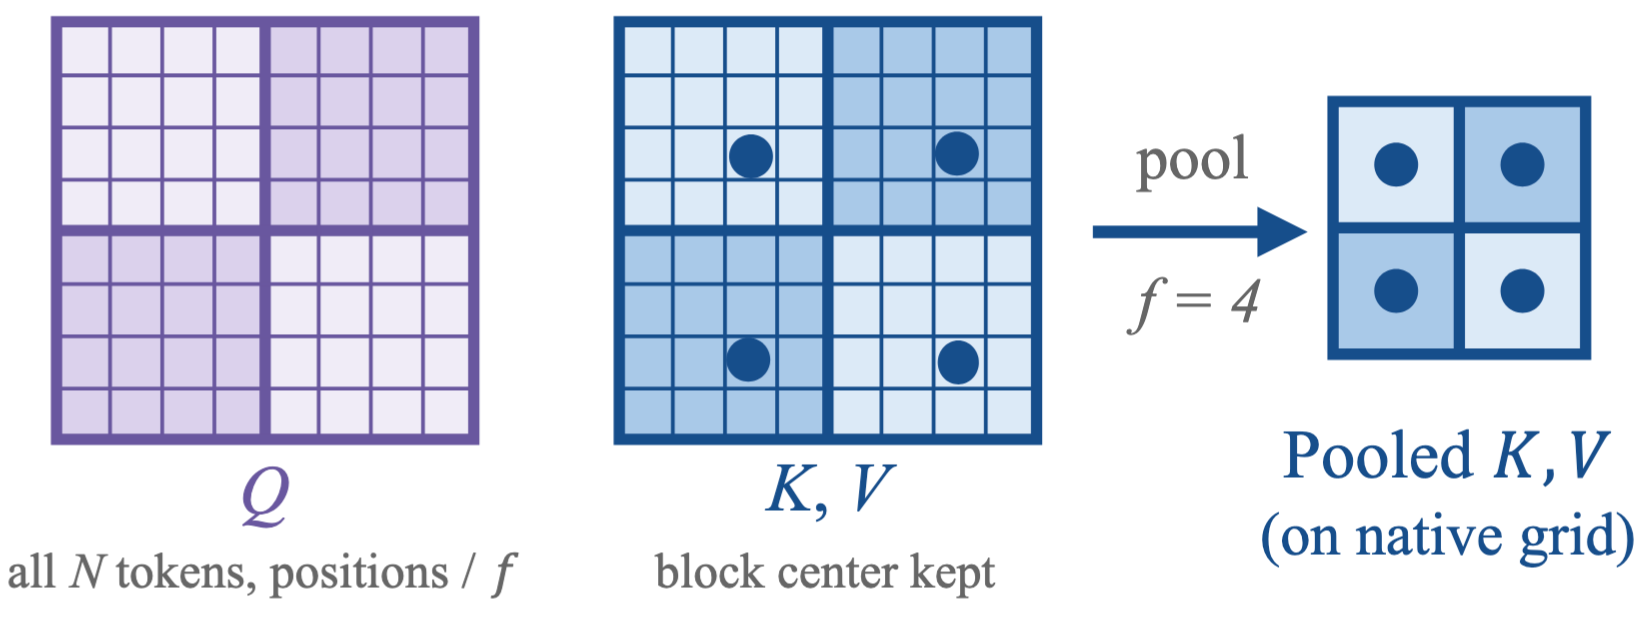
- 将 Q 的坐标也进行缩放,使得相对位置距离在预训练的尺度。
- 池化大小随着时间变化。
- Phase 2: 自适应的窗口细粒度注意力
- 窗口边长逐渐缩缩小为预训练的尺度。
- 利用当前 Latent 的离散小波变换计算局部高频能量,对于背景等平滑区域,自动划分为更小的窗口,缩减计算量。
PMA
RoPE 把每个 token 的向量按位置
也就是说,RoPE 把"绝对位置"变成了"频率编码的相位差",注意力分数只看
真实的注意力分数 = 内容相似度 × 位置相位 两者混在一起。你想知道"位置本身贡献了多少",但直接看某个 token 对的分数,分不清是内容像还是位置近。
作者的做法:把
一句话:
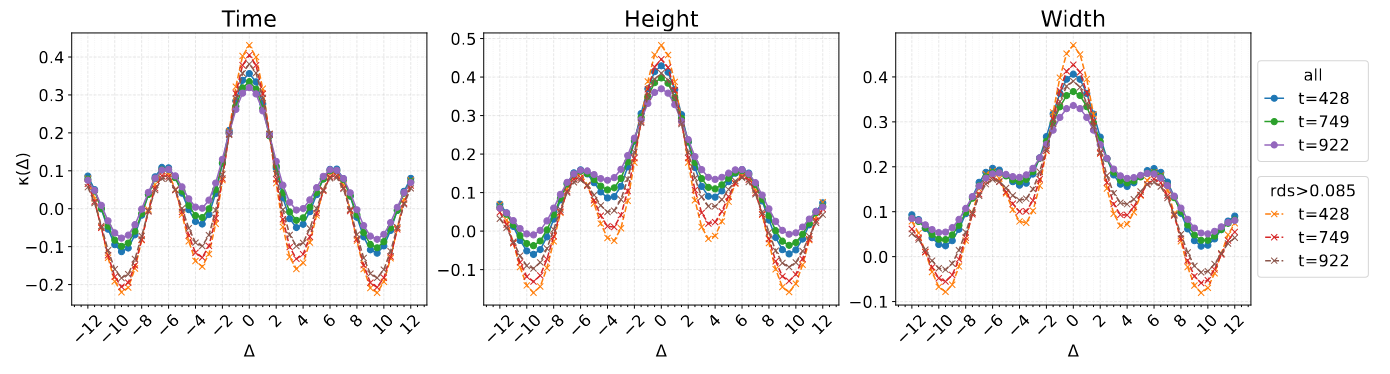
训练时所有 token
共享同一个位置尺度,模型学会在这条固定周期曲线上工作。一旦把
LR 和 HR 塞进同一坐标系,至少一组 token 的
所以论文是怎么做的?
- 首先低分辨率下去噪。
- 然后用DeepGaze找到人眼觉得重要的区域。
- 把重要区域切分成 HR Token,其余的保持 LR。
- 混合在一起去噪。让每个 Query 用自己的尺度去量 Key 的距离。
SigMA
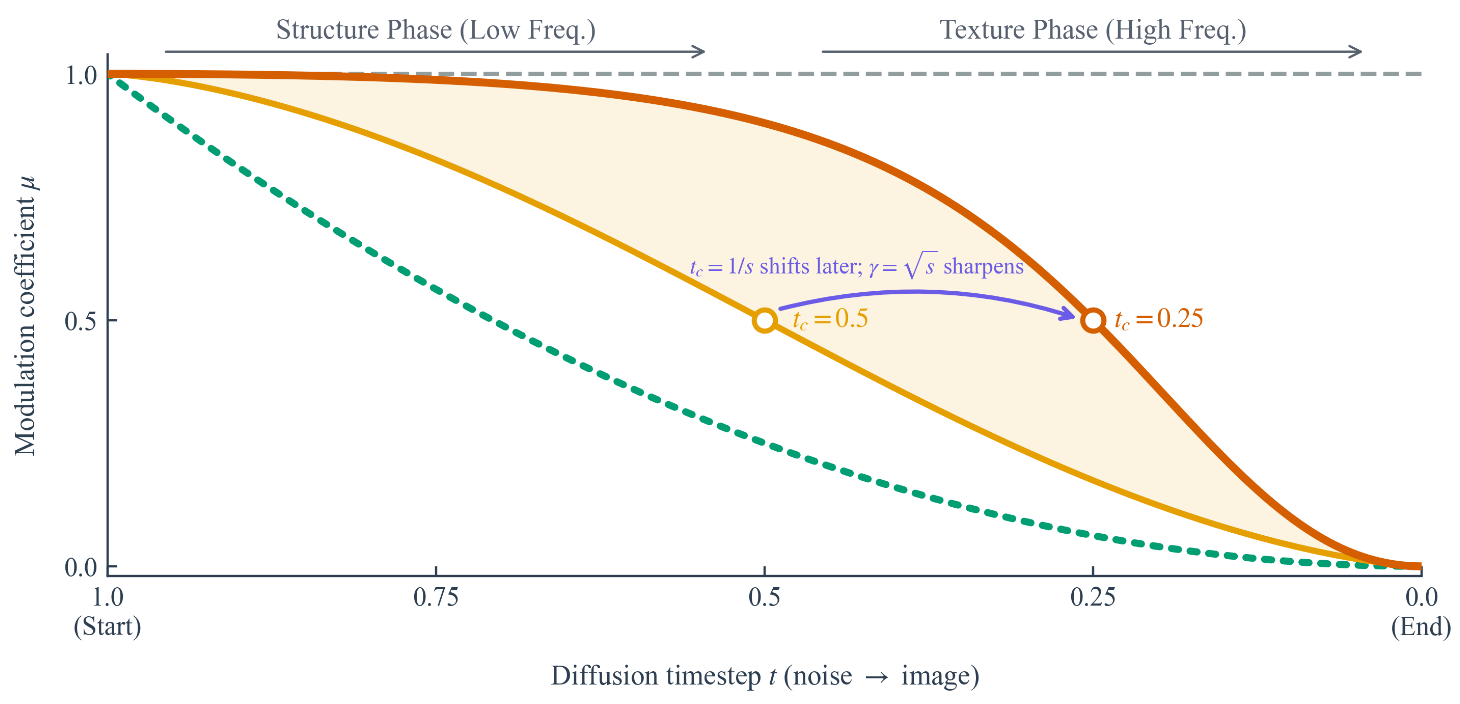
在更高分辨率下,同一个语义结构(如地平线、人物轮廓)跨越了更多的像素。扩散模型需要更长的去噪时间(即到达更干净、信噪比更高的时间步
在
如何解决?
对于放大倍数
- 当
(去噪初期,结构阶段): ,保持强位置干预,确保全局结构稳定。 - 当
(去噪末期,纹理阶段): ,放松位置干预,恢复原生 RoPE 的高频细节表达能力。 - 当某维度未放大(
)时,保持原生编码不变。
为了避免人工调参,作者通过理论推导给出了决定 Sigmoid
曲线形态的两个核心参数——相变中心