Loop Diffusion Transformer
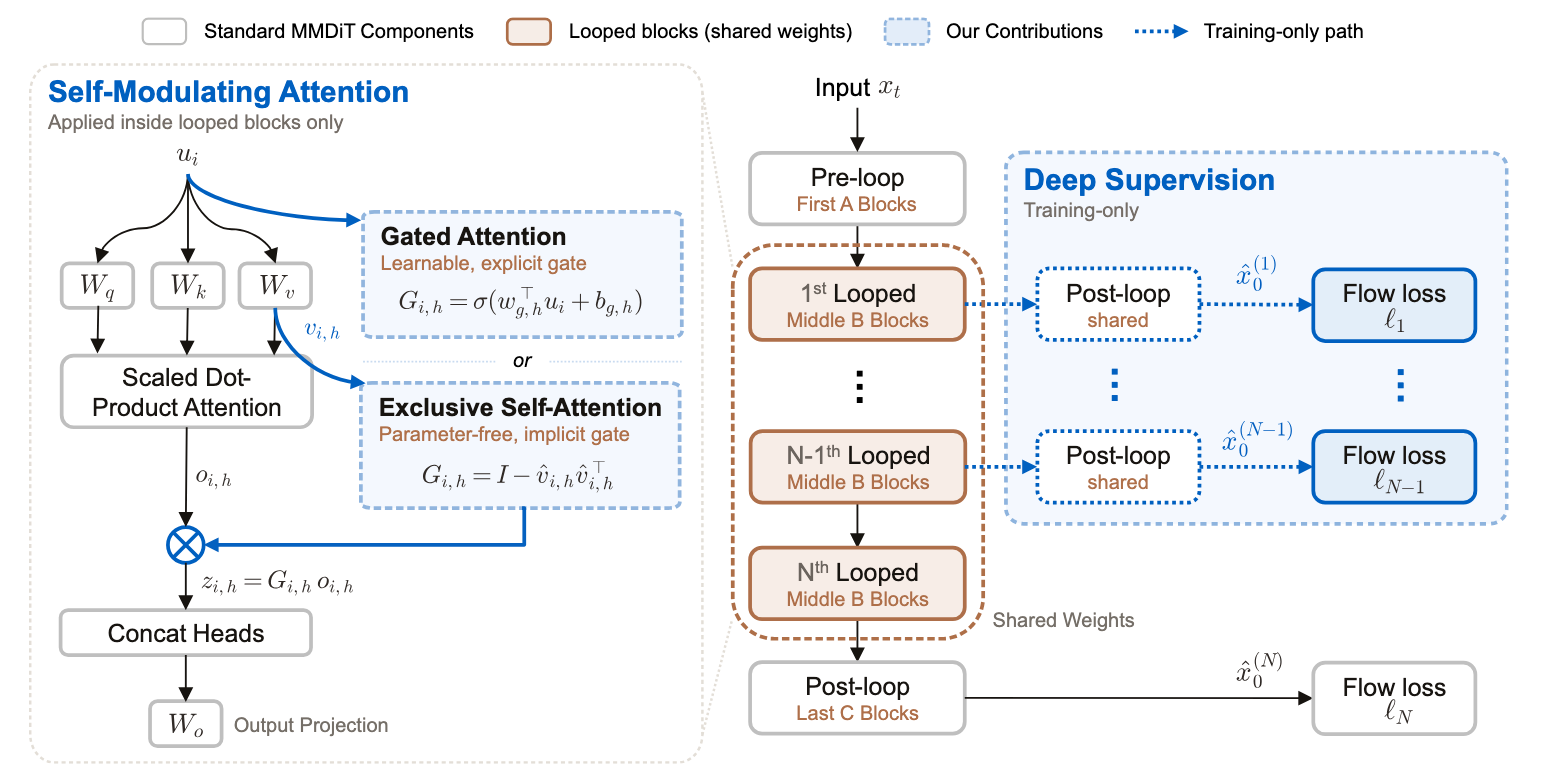
image.png

什么是 XSA?

我们先看看标准注意力:

对 token 的第 个注意力头,标准输出是:

其中 是 token 分配给源 token 的注意力权重, 是 的 value 向量,求和遍历图像和文本的所有 token。

但是注意当 时,这一项 就是 token 把自身的 value 写回自己。论文的观察是:标准 softmax 注意力能控制各源 token 的相对贡献,但控制不了更新本身的强度。循环反复应用同一组块时,这些更新会变得冗余,逐步覆盖或削弱图像 token 的表示。

XSA 先定义 token 自身 value 的单位向量:

然后定义调制算子为一个投影矩阵:

这是一个正交投影,把向量投影到与 正交的子空间。把它作用在注意力输出上:

由于 ,token 自身的 value 贡献被完全消除。

注意:XSA 不等价于简单地把注意力输出乘以 。因为投影不仅移除了 token 的直接自 value 项,还移除了其余 value 向量中沿该 token 自身 value 方向的分量。

用一句话概括:

text
1
2
标准注意力:输出 = 自身贡献 + 他人贡献
XSA:输出 = 他人贡献中,去掉"看起来像自身"的那部分

Loop Diffusion Transformer
https://d4wnnn.github.io/2026/10/21/Notion/Loop Diffusion Transformer/
作者
D4wn
发布于
2026年10月21日
许可协议